배경
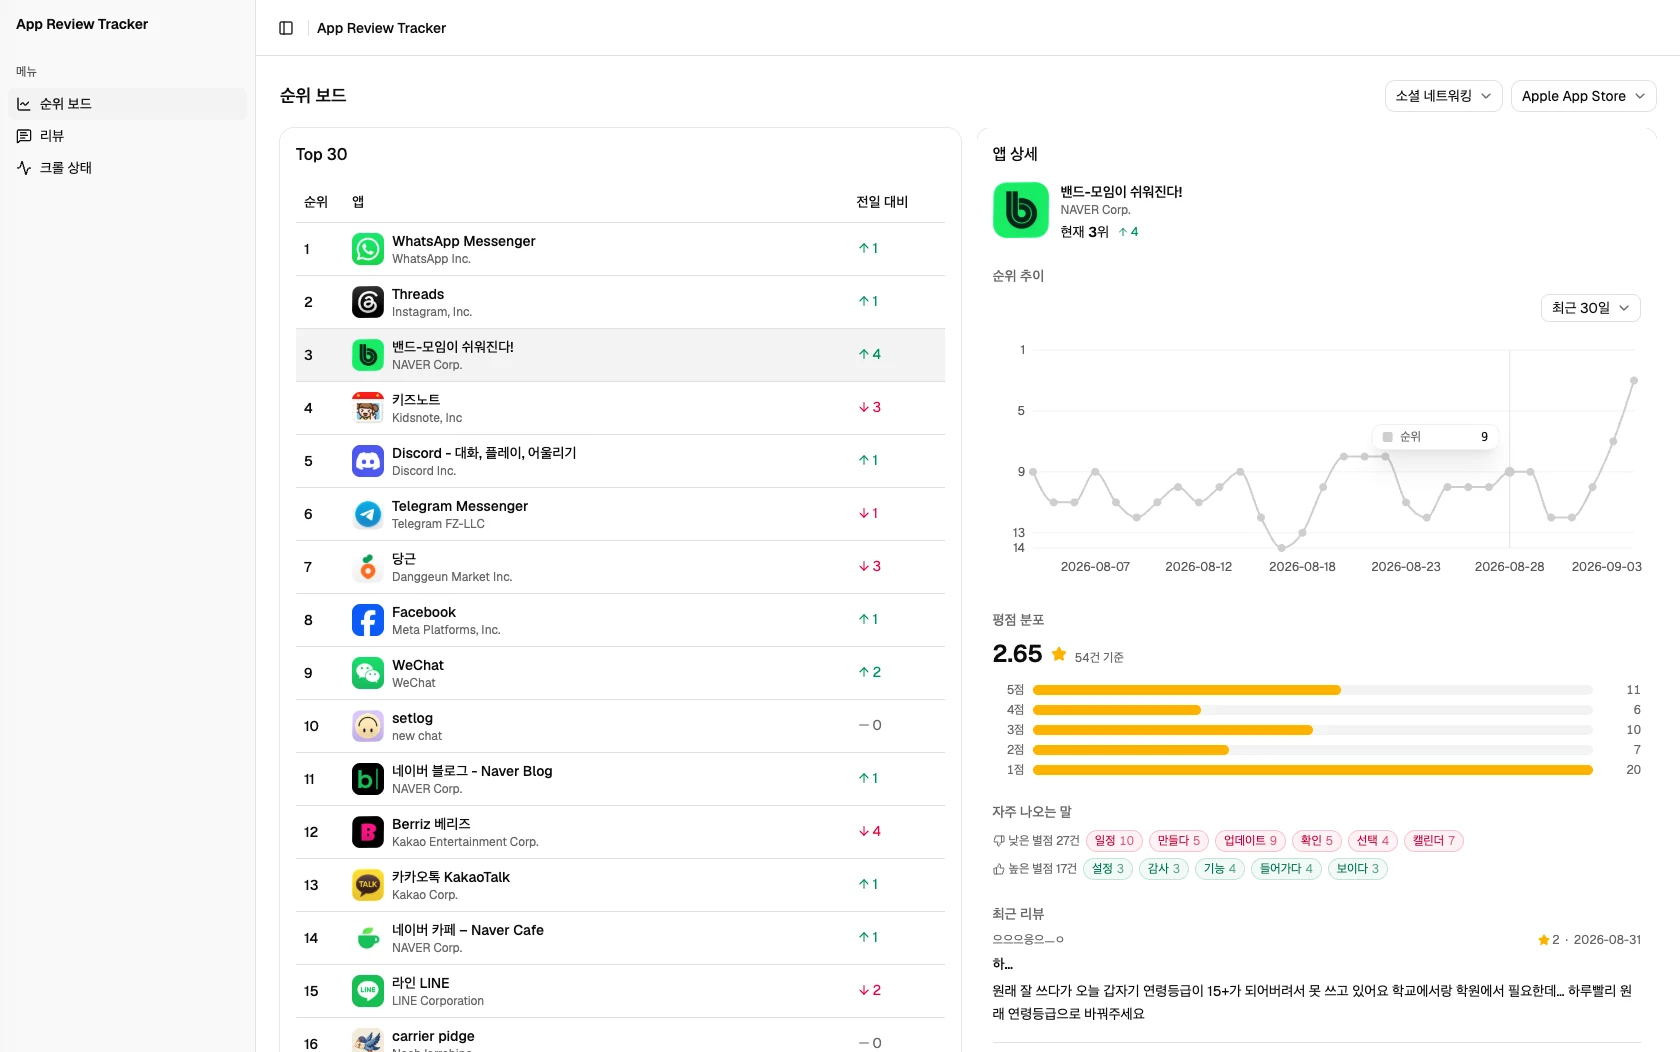
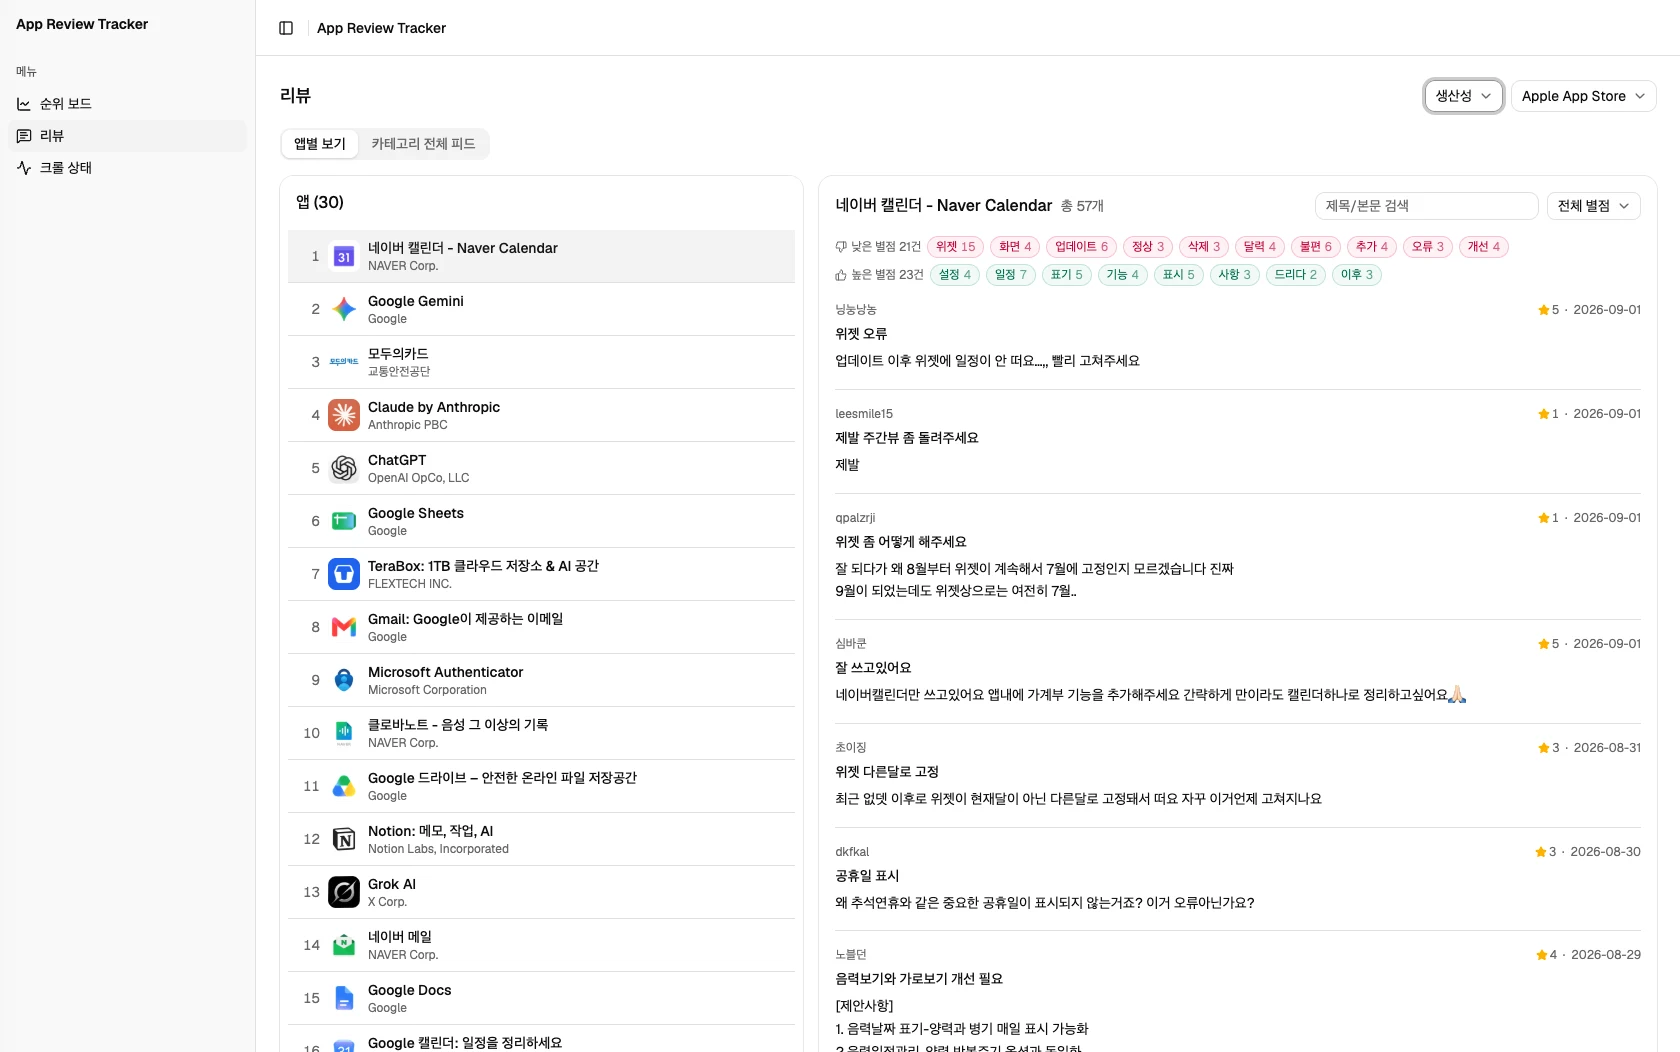
2022년, 재직 중이던 회사에서 같은 문제의식으로 기획했다가 스캐폴딩 단계에서 중단한 프로젝트가 있었다. 퇴사 후 그 문제의식만 이어받아 처음부터 다시 시작했다 — 앱의 순위와 리뷰는 매일 흘러가 버리는 데이터이고, 쌓아두지 않으면 추이를 볼 수 없다.
AI 페어 개발에서 사람의 일
이 프로젝트의 코드 작성 주체는 AI다. 그래서 본인의 역할은 코드를 치는 것이 아니라, AI의 산출물과 진단을 믿을 수 있는지 검증하는 것이었다.
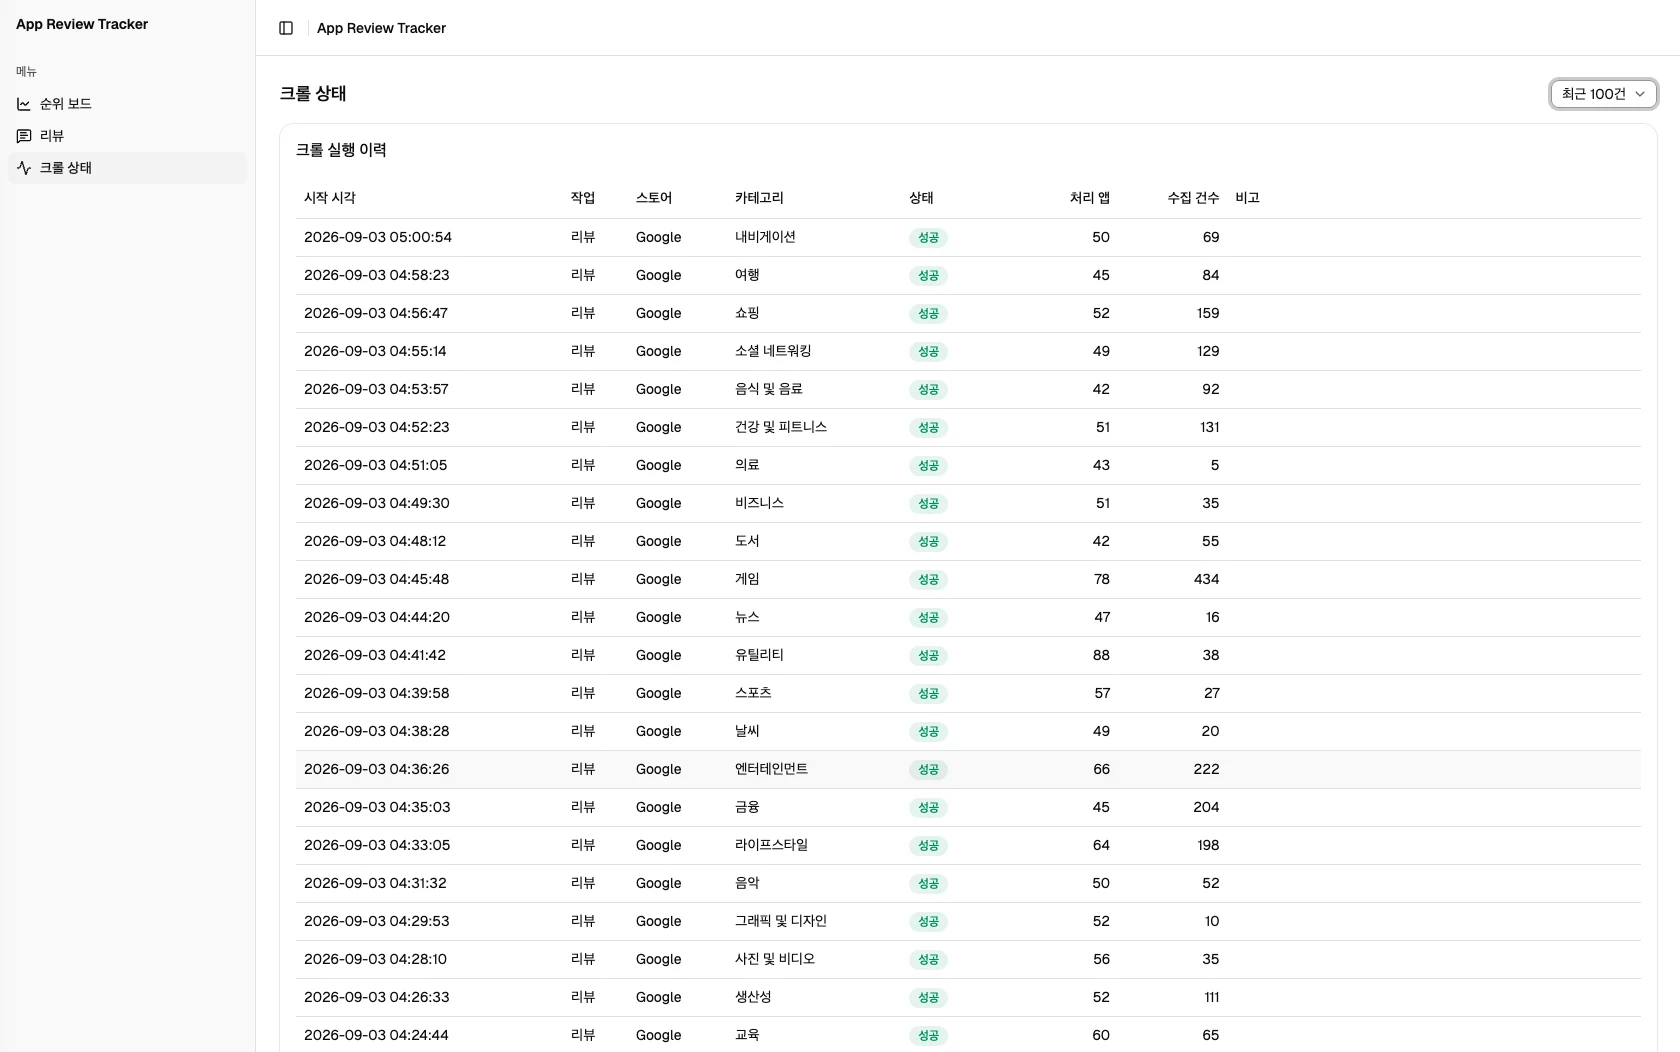
대표적인 사례가 9일간의 수집 실패다. AI는 원인을 rate limit으로 진단하고 예외명까지 그렇게 굳혀둔 상태였다. 브라우저에 URL을 직접 입력하는 A/B 실험으로 실제 원인이 URL 세그먼트 순서임을 규명했고, 같은 초에 두 순서를 비교해 순서가 결정적임을 확인했다. 진단이 틀렸음이 확인된 뒤에는 예외명을 관측 사실만 서술하도록 바꿨다.
반대 방향의 사례도 있다. 실패율이 이틀 연속 급등했을 때 AI는 수집 간격 복귀를 권했지만, 동일 조건에서 낮은 실패율이 관측된 날이 이미 있다는 반례를 들어 설정을 유지하고 하루 더 관측하기로 했다. 다음 날 실패율은 정상으로 돌아왔다. 그때 되돌렸다면 "간격 복귀 덕분에 회복됐다"는 틀린 귀속이 기록에 남았을 것이다.
기준을 정하고, 지키기
실험 게이트는 관측하기 전에 문서로 고정하고, 결과가 게이트를 벗어나면 게이트를 고치는 대신 결과를 보류했다. 수집 간격 실험은 채택 조건을 완화하지 않은 채 채택된 값 없이 종료했고, 현재 운영값이 기준선보다 실패율이 높다는 사실도 기록에 남겼다. 데이터 파이프라인에서 신뢰할 수 있는 것은 완벽한 수치가 아니라, 한계까지 적힌 수치라고 판단했다.